TypeSafe Jev: AI, která vrací rozhodnutí, ne text
TypeSafe představil System One modely a první z nich, Jev. Místo textu vrací typované odpovědi s kalibrovanou pravděpodobností, za desítky milisekund a za zlomek ceny LLM. Co to znamená pro automatizaci ve firmách a jak to zkoušíme v A1Hire.
Sedmnáctého září 2026 otevřel TypeSafe early access k modelu Jev a s ním představil novou třídu modelů, kterým říká System One. Oznámení najdete na typesafe.ai. Na první pohled další AI model. Na druhý pohled odpověď na otázku, kterou si klademe u každého firemního projektu: proč je AI už roky lepší než člověk v chatu, a přesto většina automatizace pořád stojí na ručně psaných pravidlech?
Tenhle článek je shrnutí toho, co TypeSafe tvrdí, co z toho dává smysl pro české firmy a co jsme si na Jevu zatím sami ověřili.
Chat je vyřešený, automatizace ne
Zakladatel TypeSafe Diogo Almeida pracoval v OpenAI na metodách, díky kterým jazykové modely začaly poslouchat instrukce, a později na výzkumu za ChatGPT. Jeho výchozí otázka zní: modely jsou v konverzaci nadlidské už několik let, tak kde je všechna ta automatizace?
Jeho odpověď: jazykové modely jsou stavěné pro lidi. Vracejí text, generují ho token po tokenu, trvá jim to sekundy až minuty a jejich jistota se špatně měří. Software ale nepotřebuje odstavec. Potřebuje odpověď typu „tohle je reklamace, s pravděpodobností 0,93“, na kterou může navázat další řádek kódu.
Co je System One model
Název odkazuje na Kahnemanovo rozdělení myšlení na rychlý, intuitivní Systém 1 a pomalý, uvažující Systém 2. System One model nepíše úvahy. Dostane nestrukturovaný vstup (text, stav aplikace, JSON) a vrátí typovanou odpověď s kalibrovanou pravděpodobností. TypeSafe to popisuje jako volání funkce s inteligencí frontier modelu: dovnitř jde stav, ven jde rozhodnutí.
Z toho plynou tři vlastnosti, které u LLM nemáte:
- Žádné typové chyby. Model vybírá z odpovědí, které jste mu definovali. Nemůže vymyslet kategorii, která neexistuje, ani vrátit číslo mimo rozsah. TypeSafe to formuluje ostře: halucinace tohoto druhu nejsou vzácné, jsou matematicky nemožné.
- Kalibrovaná jistota. Ke každé odpovědi dostanete pravděpodobnost, která odpovídá skutečné přesnosti. Když model řekne 0,7, má pravdu zhruba v sedmi případech z deseti. Trénink na to má vlastní metodu, kterou TypeSafe nazývá RLCD (Reinforcement Learning for Calibrated Decisions), místo klasického RLHF optimalizovaného na to, co se líbí lidem.
- Všechny odpovědi naráz. Jev negeneruje sekvenčně. Položíte mu deset otázek nad jedním stavem a dostanete deset odpovědí v jednom průchodu.
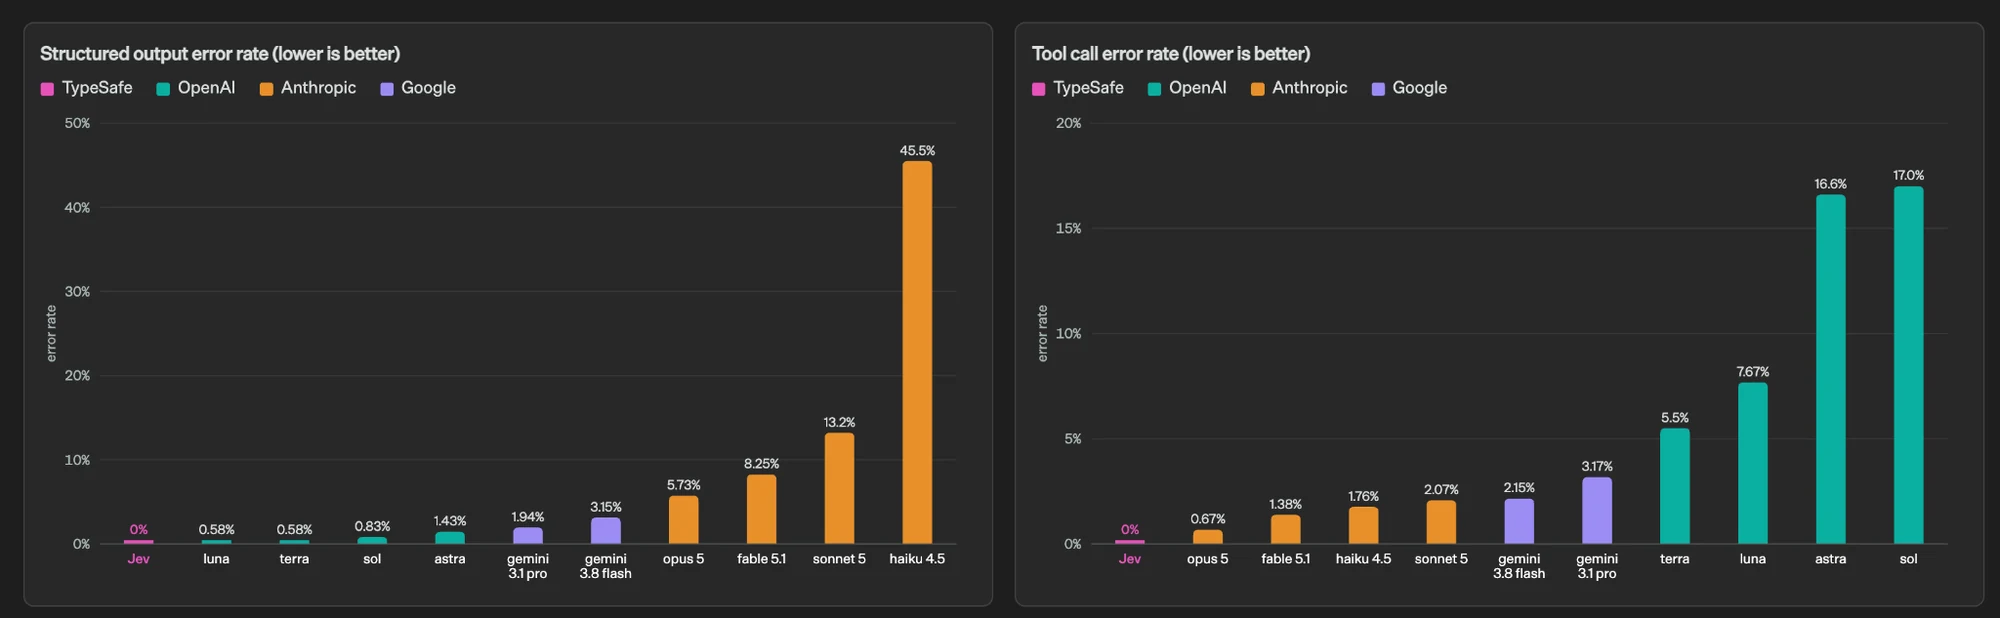
Ten první bod TypeSafe dokládá měřením. U jazykových modelů je chybovost strukturovaného výstupu, tedy odpovědi, která neodpovídá zadanému schématu, mezi 0,58 % a 45,5 % podle modelu; u volání nástrojů mezi 0,67 % a 17 %. U Jeva je v obou případech nula, ne proto, že by byl pečlivější, ale proto, že jiný než správně typovaný výstup vyrobit neumí.
Čísla, která TypeSafe uvádí
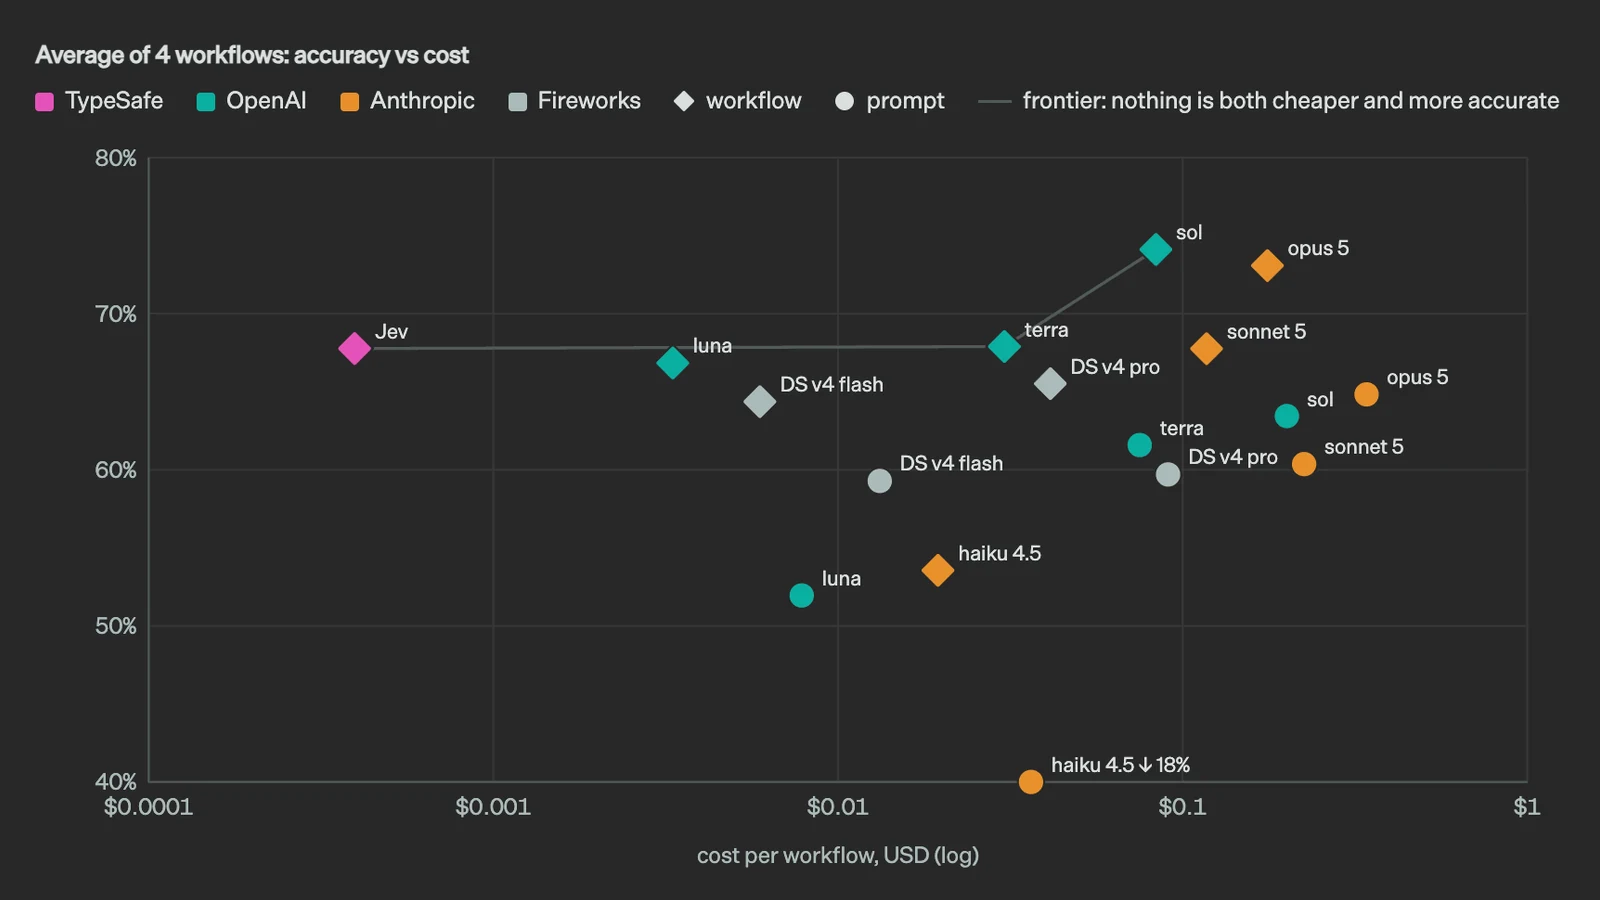
Rychlost: 70 až 500 milisekund na celý požadavek, proti 3 až 329 sekundám u jazykových modelů na stejných úlohách. TypeSafe mluví o 40× až 200× rychlejší odpovědi při srovnatelné inteligenci na strukturovaných úlohách; v jejich evaluacích pracovních postupů vyšlo 193,6× rychleji a 444,6× levněji, s poznámkou, že jde o horní hranici reálných zisků.
Graf pochází z oznámení TypeSafe: průměr čtyř workflow, přesnost proti ceně za jeden průchod v logaritmickém měřítku. Jev sedí na hranici vlevo, kde nic není zároveň levnější a přesnější.
Cena: 0,042 USD za milion vstupních tokenů, výstup zdarma. Pro srovnání, jazykové modely stojí 0,20 až 10 USD za milion vstupních tokenů a výstupní tokeny jsou zhruba pětkrát dražší.
Za pozornost stojí, že TypeSafe své evaluace sám zpochybňuje: testovací workflow psal jejich vlastní tým, srovnávané LLM běžely přes obálku vynucující strukturovaný výstup, a výběr modelů může být vychýlený. Tohle otevřené přiznání je v oznámeních AI firem vzácné a bereme ho jako dobré znamení.
Tři typy otázek
Jev neodpovídá na „co si o tom myslíš“. Odpovídá na tři druhy otázek, ze kterých se skládá všechno ostatní:
- Choice: jedna možnost z definované množiny. Která kategorie, který příjemce, která z pěti akcí.
- Noul: platí podmínka, nebo ne. Pravděpodobnost ano. Jedna otázka na každý štítek, který může platit nezávisle.
- Score: míra na popsané škále. Ne „ohodnoť od 1 do 10“, ale úrovně, z nichž každá popisuje konkrétní situaci.
Klíčové je rozdělení práce: kód vlastní postup, model dodává zdravý rozum tam, kde běžný kód potřebuje porozumět významu. Pravidla, výpočty, vyhledávání a exekuce zůstávají v kódu. Model se ptáte jen na to, co se pravidly napsat nedá.
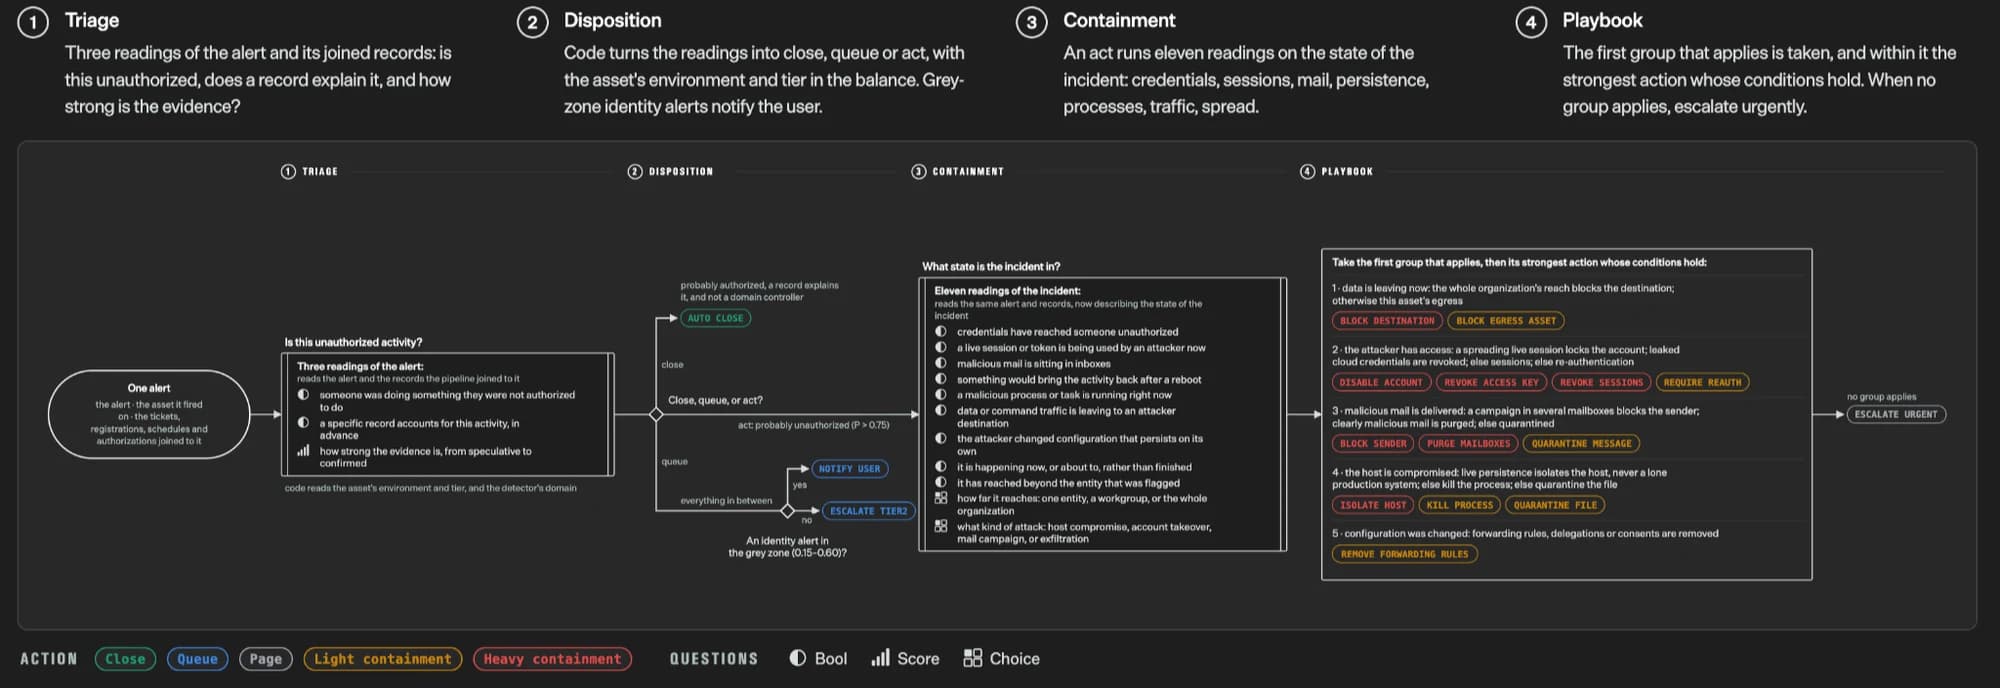
Takhle to vypadá v praxi na příkladu, který TypeSafe používá: jeden bezpečnostní alert projde čtyřmi kroky. V triáži tři otázky (je to neoprávněné, vysvětluje to nějaký záznam, jak silný je důkaz). Kód z odpovědí rozhodne, zda alert zavřít, zařadit do fronty nebo jednat. Při zásahu jedenáct dalších otázek popíše stav incidentu a playbook v kódu vybere akci. Model nikde nerozhoduje sám; odpovídá na otázky, které mu kód položí.
Kde to dává smysl
TypeSafe ukazuje dvě dema: bota hrajícího Doom, který každých sto milisekund rozhoduje nad strukturovaným stavem hry, a bota, který prochází Wikipedii a v každém kroku vybírá jeden z tisíců odkazů, aniž by si jediný vymyslel. Hezké, ale firemní využití je prozaičtější:
- Routing a klasifikace: příchozí e-mail, ticket nebo dokument zařadit a poslat správnému člověku, v reálném čase, za setinu haléře.
- Skórování a řazení: kandidáti, poptávky, dodavatelé, rizika. Skóre po dimenzích, které si pak kód váží podle vaší politiky, bez opakovaného volání modelu.
- Extrakce výběrem: kód najde kandidátní hodnoty v textu, model vybere tu správnou. Nikdy nevrátí datum, které v dokumentu není.
- Ověřování: kontrola, zda odpověď jazykového modelu odpovídá zdroji, detekce pokusů o obejití pravidel, druhý názor za milisekundu.
- Cokoli, kde záleží na latenci: rozhodnutí uvnitř běžící aplikace, ne po minutě čekání.
Jak jsme to použili v A1Hire
A1Hire hodnotí životopisy podle kategorií, které si náborář sám nastaví: každá má váhu a označení „musí“ nebo „výhodou“, k tomu vylučovací kritéria. V produkci dnes skóre počítá jazykový model Gemini 3.1 Flash Lite, který dostane CV, zadání pozice a schéma odpovědi, a vrátí JSON. Funguje to, ale je to přesně ten případ, o kterém TypeSafe mluví: chceme čísla, ne text, a přesto platíme za generování textu.
Na testovací větvi jsme proto hodnocení přepsali na Jev. Celé CV s pozicí a kritérii jde jako jeden stav a Jev v jednom požadavku odpoví na sadu typovaných otázek:
- Score pro každou kategorii: úroveň na škále, jejíž stupně popisují konkrétní situace („3 a více let praxe v Reactu v komerčním projektu“), převedená na skóre 0 až 100 a doplněná jistotou.
- Noul pro každé vylučovací kritérium: platí, nebo ne, s pravděpodobností.
- Noul pro upozornění, že CV obsahuje citlivé údaje podle čl. 9 GDPR, které se v hodnocení nesmějí použít.
- Choice pro jméno kandidáta, vybrané z textu CV, nikdy vymyšlené.
Text, tedy komentář k pohovoru, silné stránky a otázky na míru, generuje dál Gemini, ale jen když o něj náborář výslovně požádá. Skóre od Jeva přitom nemění.
Co to přineslo: rychlost a cena
Změřeno na stejném životopisu, stejné pozici, pěti kategoriích a dvou vylučovacích kritériích, třikrát po sobě z Prahy, ceníkové sazby obou poskytovatelů:
- Rychlost hodnocení jednoho CV: Jev 0,3 až 0,8 sekundy, Gemini 3.1 Flash Lite 2,5 až 2,7 sekundy. Zhruba pětkrát až devětkrát rychleji.
- Cena hodnocení jednoho CV: Jev 0,0023 Kč (2 420 vstupních tokenů, výstup zdarma), Gemini 0,032 Kč. Čtrnáctkrát levněji.
- Dávka: dvacet CV posíláme paralelně v jednom požadavku a celá dávka je hotová pod jednu sekundu. Sto padesát životopisů na jednu pozici, které dřív znamenaly minuty čekání, je otázka několika sekund.
- Shoda skóre: na stejném CV dal Jev v kategorii React 96 bodů, Gemini 95. Pořadí kategorií vyšlo u obou stejně, Jev je o něco konzervativnější u dovedností, které CV jen zmiňuje.
- Text je to drahé: komentář a osm otázek k pohovoru od Gemini trvají 3,9 sekundy a stojí 0,061 Kč, tedy šestadvacetinásobek samotného hodnocení. Proto je v A1Hire na vyžádání, ne automaticky.
V praxi to znamená, že vyhodnocení sta životopisů stojí 0,23 Kč místo 3,20 Kč. To samo o sobě nikoho nezachrání, ale mění to, co si můžeme dovolit: hodnotit každé CV znovu při každé změně kritérií, zkoušet varianty vah, nebo nechat náboráře přehodnocovat bez počítání kreditů.
Co jsme se naučili: největší práce není v kódu, ale v otázkách. Score musí mít úrovně, které popisují konkrétní situace, ne přídavná jména. A kalibrovaná jistota je v náboru cennější než samotné skóre, protože říká, které kandidáty má člověk přečíst pozorně.
Hodí se k tomu i zkušenost z MedShiftu, kde generátor rozpisů záměrně není jazykový model, protože zákoník práce se nesmí odhadovat. System One modely jsou přesně ten střed mezi tvrdým algoritmem a volným chatem: rozhodnutí, které je typované a měřitelné, ale rozumí významu.
Kde to nepoužít
Jev nepíše. Nenapíše shrnutí, e-mail ani zdůvodnění. Nevybere hodnotu, kterou jste mu nenabídli. A typovaný výstup zaručuje tvar odpovědi, ne její pravdivost: model je trénovaný na kalibrovaná rozhodnutí obecně, jeho přesnost ve vaší doméně musíte změřit na vlastních datech, stejně jako u čehokoli jiného.
Jak začít
Jev je v early accessu; TypeSafe pouští vývojáře z čekací listiny postupně. Dokumentace včetně příkladů je na docs.typesafe.ai. Pokud ve firmě máte proces, kde se dnes ručně třídí, řadí nebo schvaluje, a chcete vědět, jestli se dá postavit na typovaných rozhodnutích, ozvěte se A1 GEN Studiu. Rádi ukážeme, co jsme si na tom sami vyzkoušeli.